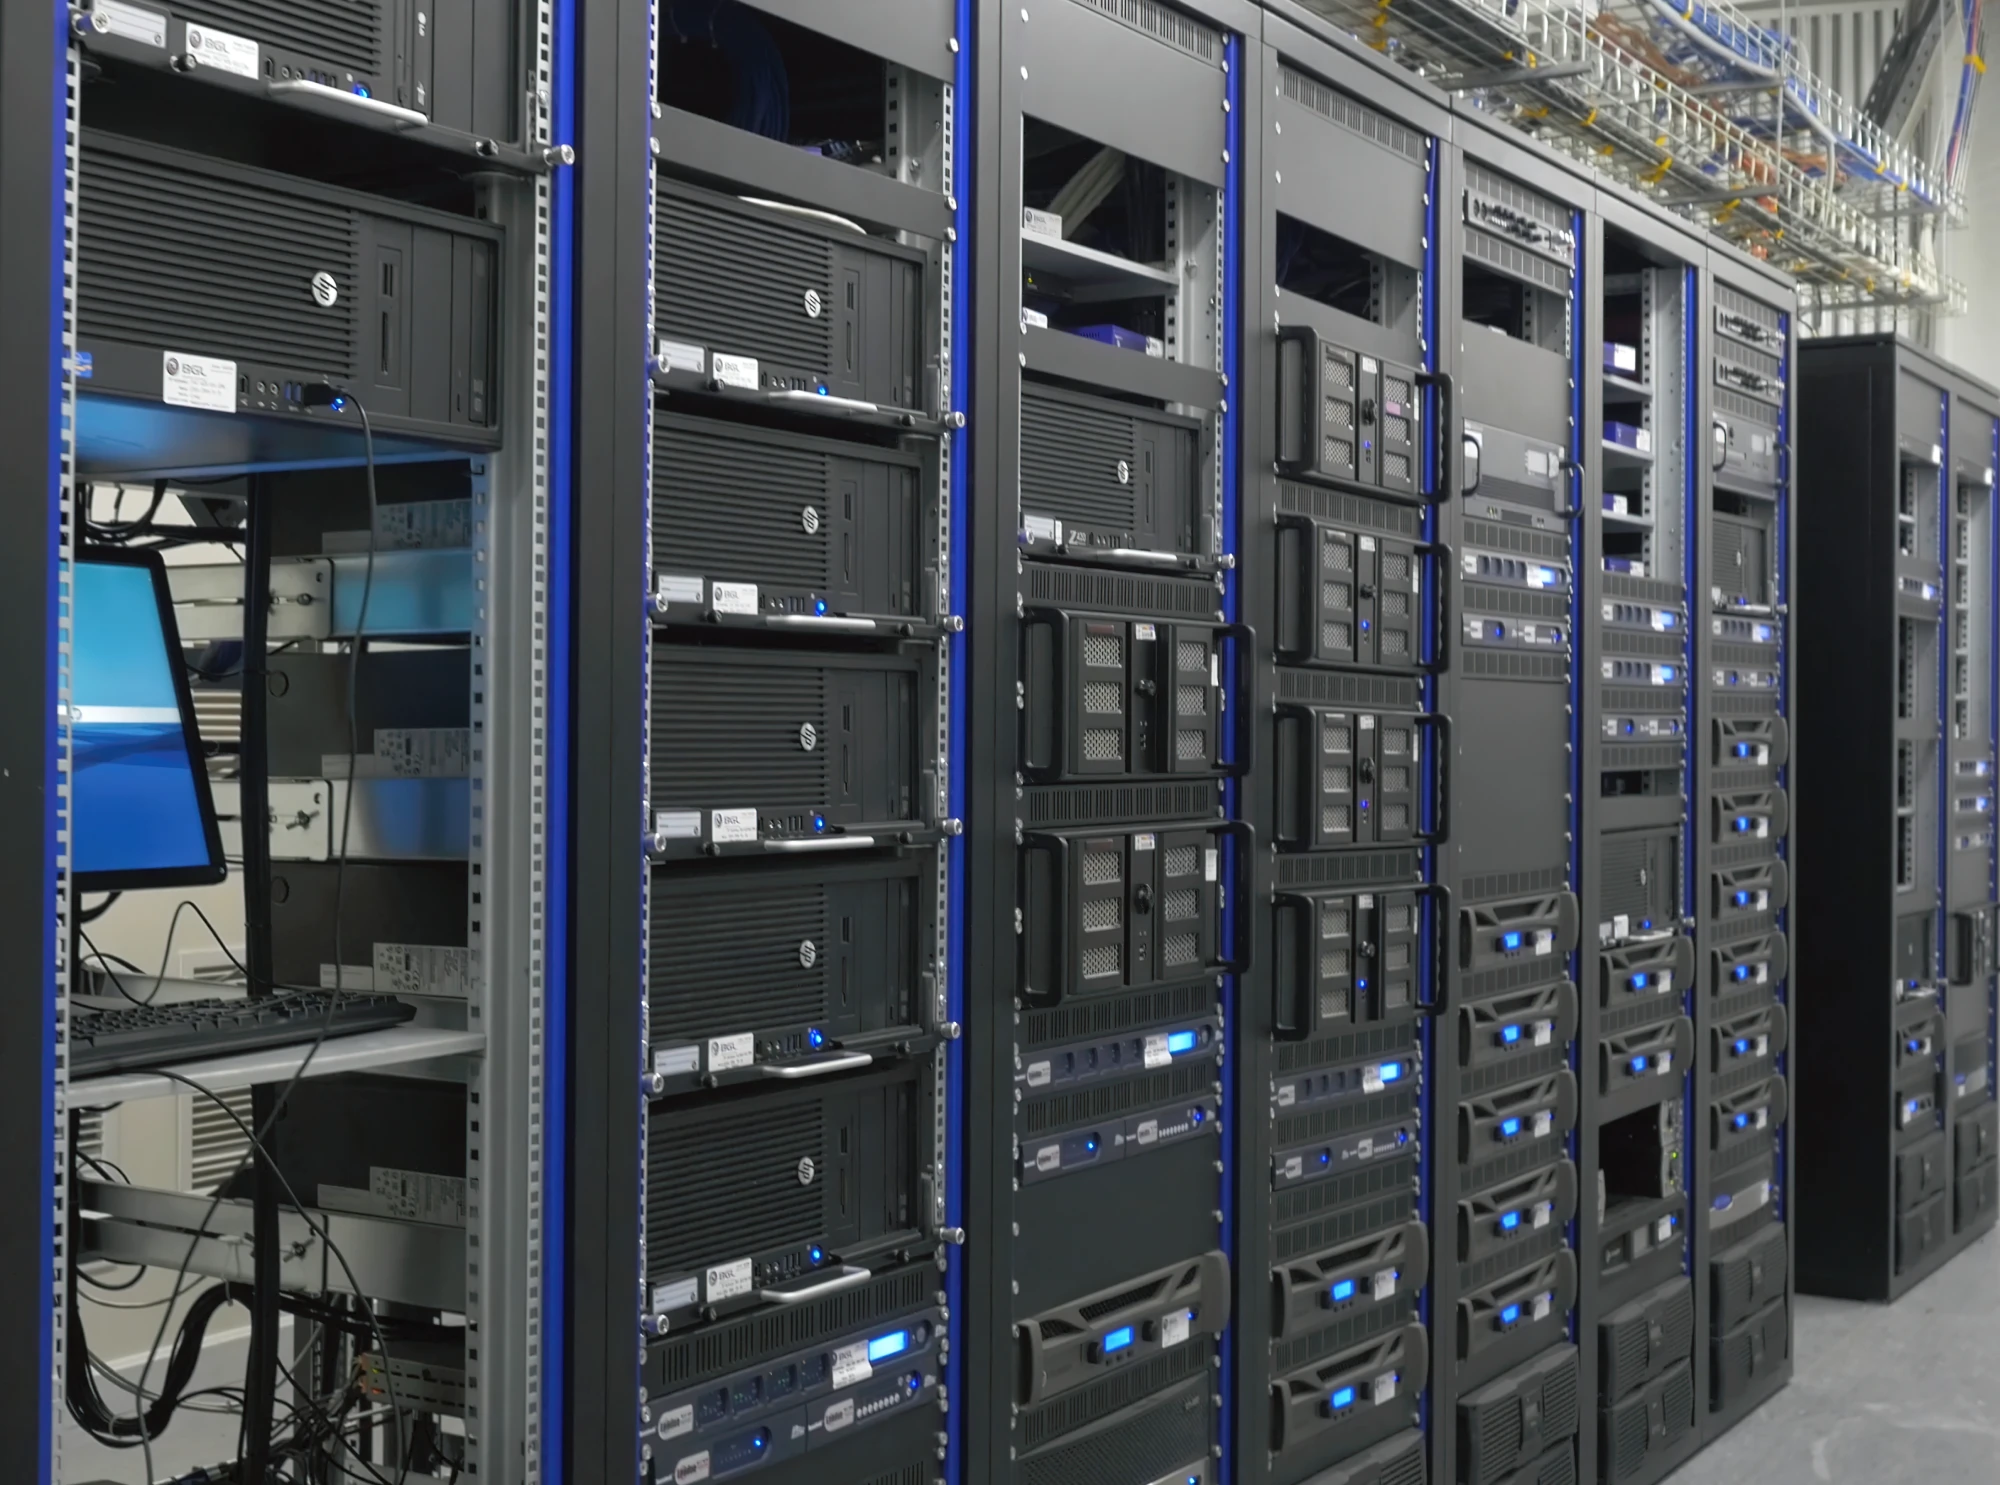
Eigene KI statt fremder Cloud: Mit einem GPU-Server betreiben Sie Sprachmodelle, Bildgenerierung oder Machine-Learning-Pipelines auf Hardware, die nur Ihnen gehört – mit planbaren Kosten und ohne dass Ihre Daten Europa verlassen.
Für KI gebaut
Aktuelle NVIDIA-Rechenzentrums-GPUs mit viel Grafikspeicher – für Training, Fine-Tuning und schnelle Inferenz.
Ihre Daten bleiben in der EU
Hosting in Österreich und Deutschland statt US-Hyperscaler – wichtig für Kundendaten, Geschäftsgeheimnisse und die DSGVO.
Persönliche Beratung
Wir stellen Ihren Server nach Ihrem Anwendungsfall zusammen: Welche GPU, wie viel VRAM, wie viele Karten – ehrlich und verständlich erklärt.
Planbare Monatskosten
Fester Monatspreis statt minutengenauer Cloud-Abrechnung – bei Dauerbetrieb meist deutlich günstiger als GPU-Instanzen in der Cloud.
Unsere GPU-Modelle
| GPU | Grafikspeicher | Stärken |
|---|---|---|
| NVIDIA RTX PRO 6000 | 96 GB GDDR7 | Blackwell-Generation, sehr gutes Preis-Leistungs-Verhältnis für Inferenz, mittelgroße LLMs, Bildgenerierung und Rendering |
| NVIDIA H100 | 80 GB HBM3 | Der Standard für KI-Training und Fine-Tuning, sehr hohe Speicherbandbreite |
| NVIDIA H200 | 141 GB HBM3e | Für große Sprachmodelle und lange Kontexte – mehr Modell passt in eine einzelne GPU |
Verfügbarkeit, Anzahl der GPUs pro Server und Konfiguration auf Anfrage. Auch Server mit mehreren GPUs sind möglich.
Einsatzbereiche
- Eigene LLMs betreiben (z. B. Llama, Mistral, Qwen)
- Fine-Tuning auf Unternehmensdaten
- RAG-Systeme & interne KI-Assistenten
- Bild-, Video- & Sprachverarbeitung
- 3D-Rendering & Simulation
- Forschung & wissenschaftliches Rechnen
Software-Stack
Auf Wunsch liefern wir den Server mit vorinstallierten Treibern und CUDA-Umgebung aus.
Welche GPU brauche ich?
Entscheidend ist vor allem der Grafikspeicher (VRAM): Das Modell muss vollständig hineinpassen, um schnell zu laufen. Als Faustregel braucht ein Sprachmodell in 16-Bit-Genauigkeit etwa 2 GB VRAM pro Milliarde Parameter, quantisiert (z. B. 4-Bit) deutlich weniger. Ein 70-Milliarden-Parameter-Modell läuft quantisiert gut auf einer RTX PRO 6000; für Training oder unquantisierte große Modelle sind H100 oder H200 – oder mehrere GPUs – die bessere Wahl. Ausführlicher erklären wir das im Ratgeber GPU-Server für KI: Worauf es ankommt.
GPU-Server statt Cloud?
Cloud-GPUs sind praktisch für kurze Experimente. Laufen Ihre Modelle aber dauerhaft – etwa ein interner Chatbot oder eine KI-Funktion in Ihrem Produkt – wird die stundenweise Abrechnung schnell teuer. Ein gemieteter GPU-Server hat einen festen Monatspreis, die Hardware gehört für die Laufzeit nur Ihnen und Ihre Daten liegen in einem europäischen Rechenzentrum statt bei einem US-Konzern.
Häufige Fragen zu GPU-Servern
Was kostet ein GPU-Server?
Das hängt stark von GPU-Modell, Anzahl der Karten und Laufzeit ab. Wir erstellen Ihnen gern ein unverbindliches Angebot – schreiben Sie uns kurz, was Sie vorhaben.
Kann ich einen GPU-Server auch nur für ein paar Monate mieten?
Ja, sprechen Sie uns an. Je nach Modell und Verfügbarkeit sind auch kürzere Laufzeiten möglich, längere Laufzeiten sind in der Regel günstiger.
Helfen Sie bei der Einrichtung der KI-Software?
Ja. Neben Treibern und CUDA richten wir auf Wunsch auch Inferenz-Server wie vLLM oder Ollama ein. Als Softwareentwickler unterstützen wir Sie auch bei der Integration in Ihre Anwendungen.
Ist ein GPU-Server DSGVO-konform?
Ja. Ihre Server stehen in Rechenzentren in Österreich bzw. Deutschland und werden von einem österreichischen Unternehmen betreut. Ihre Daten verlassen die EU nicht – anders als bei vielen KI-Cloud-Diensten.